Ne Oldu?
HAVELSAN, kamu kurumları ve özel sektör şirketlerinin sahip oldukları büyük miktardaki veriyi yapay zekâ uygulamalarında daha etkin kullanabilmesini sağlamak amacıyla ORION adlı yerli büyük veri yönetim platformunu geliştirdi. Platforma ilişkin ayrıntılar 16 Ağustos 2026 tarihinde kamuoyuyla paylaşıldı.
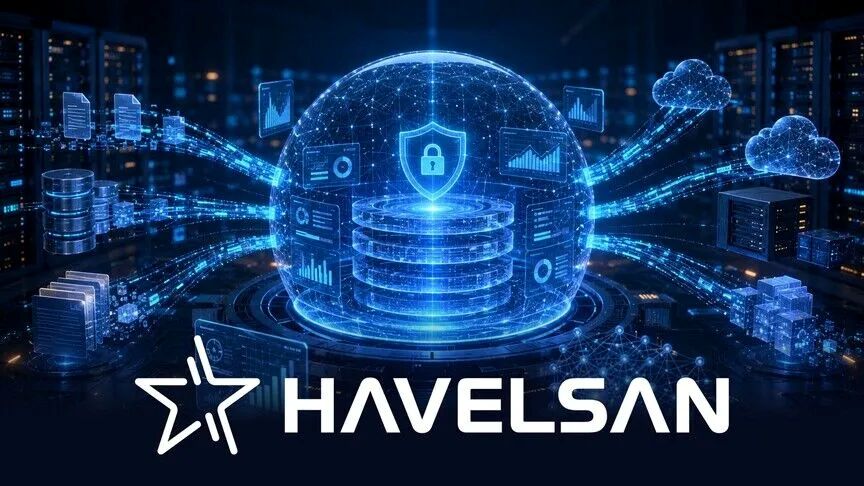
ORION; kurumların farklı veri tabanlarında, kurumsal uygulamalarda, belgelerde, sensörlerde, güvenlik ekipmanlarında ve üretim sistemlerinde bulunan verilerini ortak bir altyapı altında bir araya getirmek üzere tasarlandı. Platform verilerin toplanması, saklanması, işlenmesi, aranması ve analiz edilmesi gibi büyük veri süreçlerinin tek merkezden yönetilebilmesini amaçlıyor.
Kurumsal yapılarda üretilen verilerin farklı sistemlerde ve formatlarda tutulması, yapay zekâ projelerinin önündeki önemli sorunlardan biri olarak öne çıkıyor. Bir yapay zekâ sisteminin güvenilir sonuçlar üretebilmesi için ihtiyaç duyduğu verilerin erişilebilir, güncel ve işlenebilir olması gerekiyor. ORION bu noktada kurumun mevcut veri kaynakları ile yapay zekâ katmanı arasında veri altyapısı görevi üstleniyor.
Platform hem yapılandırılmış hem de yapılandırılmamış verilerin yönetilmesini destekliyor. Böylece veri tabanlarındaki düzenli kayıtların yanında belgeler ve farklı dijital kaynaklardan gelen veriler de analiz süreçlerine hazırlanabiliyor.
HAVELSAN'ın çözümü kamu, savunma, finans, enerji, telekomünikasyon, ulaşım, sağlık, sanayi ve araştırma gibi yüksek miktarda veri üreten sektörlerde kullanılabilecek şekilde ölçeklenebilir olarak geliştirildi. Platform kurumların veri hacmine, ihtiyaçlarına ve kullanıcı sayısına göre yatay veya dikey biçimde genişletilebiliyor.
Veriler Kurum İçinde Tutulabilecek
ORION'un dikkat çeken özelliklerinden biri “on-premises first” yani önce kurum içi yaklaşımı. Platform kurumların kendi veri merkezlerinde ve kapalı ağlarında çalıştırılabiliyor. Böylece kritik verilerin üçüncü taraf bulut altyapılarına aktarılması yerine kurum sınırları içerisinde tutulabilmesi hedefleniyor.
Bu yaklaşım özellikle kamu, savunma, finans ve sağlık gibi hassas veya kritik verilerin işlendiği alanlarda önem taşıyor. Kurumlar erişim yetkilerini kendi altyapıları içerisinde yönetebilirken veriler üzerindeki kurumsal sahipliğin korunması amaçlanıyor.
ORION ayrıca kurumların mevcut veri kaynakları ve uygulamalarıyla entegre olabilecek şekilde tasarlandı. Böylece platformun kullanılması için mevcut bilgi teknolojileri yatırımlarının tamamen değiştirilmesi gerekmiyor.
Platformun altyapısında açık kaynak teknolojilerden yararlanılıyor. HAVELSAN, farklı açık kaynak bileşenlerini kurumların ayrı ayrı kurup yönetmesi yerine bunları bütünleşik bir platform altında sunmayı hedefliyor. Bu modelle belirli bir yabancı teknoloji sağlayıcısına bağımlılığın ve lisans maliyetlerinin azaltılması amaçlanıyor.
İlk Kullanım Alanlarından Biri Türkçe Olacak
ORION'un açıklanan ilk önemli kullanım alanlarından biri Türkçenin dijitalleştirilmesine yönelik çalışma olacak. Platform, Türk Dil Kurumu ile HAVELSAN arasında yürütülecek projede kullanılacak.
Çalışma kapsamında Türkçenin geçmişten bugüne ortaya çıkan yazılı, sözlü ve görsel birikiminin dijital ortama aktarılması ve yapay zekâ teknolojileriyle analiz edilmesi hedefleniyor. Metinler ve sözlü kaynakların oluşturulacak veri tabanına aktarılması planlanıyor.
Bu veri altyapısı ilerleyen dönemde Türkçe üzerinde çalışan yapay zekâ sistemleri açısından önemli bir kaynak oluşturabilir. Büyük dil modellerinin ve diğer yapay zekâ uygulamalarının geliştirilmesinde düzenli ve erişilebilir veri kümeleri kritik rol oynuyor.
Neden Önemli?
Şirketlerin ve kamu kurumlarının yapay zekâ dönüşümünde karşılaştığı temel sorunlardan biri yalnızca güçlü modellere erişmek değil, kendi verilerini bu modellerin kullanabileceği hale getirmek. Yıllar boyunca farklı yazılımlar ve sistemler üzerinde oluşturulan kurumsal veriler çoğu zaman birbirinden bağımsız ortamlarda bulunuyor.
ORION bu soruna doğrudan veri altyapısı üzerinden yaklaşması nedeniyle önem taşıyor. Kurumların sahip oldukları bilgiyi ortak bir veri katmanında birleştirebilmesi, yapay zekâ projelerinin hazırlanmasını ve veri odaklı karar mekanizmalarının kurulmasını kolaylaştırabilir.
Platformun kurum içi çalışabilmesi ise Türkiye açısından veri egemenliği konusunu öne çıkarıyor. Özellikle stratejik verilerin yabancı bulut sağlayıcılarına aktarılmadan işlenebilmesi, kritik sektörlerde yerli yapay zekâ altyapılarının geliştirilmesine katkı sağlayabilir.
Açık kaynak teknolojilerin kullanılması da Kamuda Açık Kaynak Kodlu Yazılım Kullanımı Genelgesi doğrultusunda kamu kurumlarının yabancı yazılım ve lisans bağımlılığını azaltma hedefleriyle örtüşüyor.
Kimleri Etkiliyor?
- Kamu kurumları ve kamu bilişim ekipleri
- Yapay zekâ projeleri geliştiren Türk şirketleri
- Savunma ve güvenlik sektöründeki kuruluşlar
- Finans, enerji ve telekomünikasyon şirketleri
- Sağlık ve ulaşım alanındaki kurumlar
- Büyük veri ve veri analitiği ekipleri
- Türkçe yapay zekâ modelleri geliştiren araştırmacılar
Olası Etkileri
ORION'un kamu ve özel sektörde yaygınlaşması, kurumların yıllardır biriktirdiği ancak farklı sistemlerde dağınık halde bulunan verilerin yapay zekâ projelerinde daha etkin kullanılmasını sağlayabilir. Bu durum özellikle kurumlara özel yapay zekâ asistanları, karar destek sistemleri ve ileri analitik uygulamalarının geliştirilmesini kolaylaştırabilir.
Kurum içi çalışma modeli, hassas veriler nedeniyle genel bulut tabanlı yapay zekâ hizmetlerini kullanmakta zorlanan kuruluşlar için alternatif oluşturabilir. Böylece kritik veriler kurum dışına çıkarılmadan yapay zekâ ve analitik uygulamalarına aktarılabilir.
Açık kaynak tabanlı mimari ve yerli platform yaklaşımı, yabancı büyük veri çözümlerine yönelik lisans maliyetlerinin azaltılmasına katkı sağlayabilir. Ancak bu etkinin büyüklüğü platformun hangi kurumlarda, hangi ölçekte kullanılacağı ve mevcut sistemlerle entegrasyon performansına bağlı olacak.
Türk Dil Kurumu ile yürütülecek projenin başarılı olması durumunda ORION, Türkçe yapay zekâ ekosistemi açısından da önemli bir veri altyapısı oluşturabilir. Türkçenin tarihsel ve güncel kaynaklarının dijital olarak işlenebilir hale getirilmesi, gelecekte geliştirilecek yerli büyük dil modellerinin veri kapasitesine katkı sağlayabilir.